FlexCache
FlexCache 为扩散模型提供统一的缓存加速接口。在完整计算的步骤保存输出,在后续步骤 复用或预测部分结果,从而减少生成耗时。不同策略提供不同的速度与画面保真度取舍。
支持策略
| 策略 | 复用对象 | 当前支持 |
|---|---|---|
| FreeCache Preview | 模型输出与采样状态 | Z-Image、Qwen-Image、FLUX.1-dev |
| MeanCache | 模型输出与采样状态 | Z-Image、Qwen-Image,固定 50 steps |
| MagCache | 主干 residual | FLUX.1、Qwen-Image、Wan 1.3B 的官方 profile |
| TeaCache | block-group residual | FLUX.1、Wan 1.3B/14B 的默认标定 |
| TaylorSeer | attention、MLP 和 projection 输出 | Z-Image、FLUX.1、Qwen-Image、Wan |
| PAB | attention 输出 | Z-Image、FLUX.1、Qwen-Image、Wan |
FreeCache Preview
FreeCache Preview 内置模型 profile,无需读取实验文件或手动标定。 Fresh 预算支持 1–50 的任意整数,建议从 F25 开始。 F10 / F17 / F25 保留原有预设,其他预算自动生成调度;数字代表 50 个采样步骤中 执行完整模型计算的次数,不改变采样区间。极低预算可能明显损坏画面。
from chitu_diffusion import CacheConfig, FreeCacheConfig

cache = CacheConfig(
    strategy="freecache",
    params=FreeCacheConfig.preview("zimage", fresh_budget=25),
)
CLI 使用 --cache-strategy freecache --freecache-profile zimage:25。
完整示例、三模型参数和 Slurm 命令见 FreeCache 使用说明。
Preprocess
想使用 40 步等其他采样步数,或为自己的模型权重重新标定,可以运行
tools/freecache/run.py。
它先记录完整推理的模型输出,再加入小扰动测量误差如何传到最后,
据此选择哪些步完整计算、哪些步复用,以及复用时的外推系数。前 warmup 步始终完整计算。
标定后的配置可用于新 prompt 和 seed,推理时不用重复 preprocess。
在仓库根目录、已安装项目依赖的环境中运行;prompts.json 是
[{"id":"example","prompt":"A red cube on a white table."}] 格式的列表,实际标定请放入多种代表性场景。
例如,为 40 个采样步骤生成完整计算次数为 16、20、28 的三个配置:
sbatch --partition=debug --gres=gpu:1 --time=01:00:00 \
  --wrap='python -m tools.freecache.run \
    --model zimage --model-path /path/to/Z-Image \
    --prompts prompts.json --seeds 42 123 \
    --steps 40 --width 1024 --height 1024 --guidance 5 \
    --warmup 8 --budgets 16 20 28 --relative-epsilon 0.1 \
    --output outputs/freecache-40'
| 参数 | 含义 |
|---|---|
--model / --model-path |
当前采集入口支持 flux、qwen、zimage;路径为本地权重目录 |
--steps |
实际采样步数,默认 50,preprocess 至少需要 4 步;采集、拟合和推理必须一致 |
--warmup |
开头连续完整计算的步数,至少 2,计入预算 |
--budgets |
要生成的完整计算次数,可取 warmup 到 steps 的任意整数 |
--width / --height / --guidance |
使用实际推理的分辨率和引导强度;Qwen 对应 true_cfg_scale |
--relative-epsilon |
测传播时的扰动大小,相对于当前 latent 范数;示例 0.1 不是跨模型最优值 |
--inject-steps |
可选,指定至少两个从 0 开始的探测位置,范围 [2, steps-1];默认随总步数分布采样 |
--coherence |
误差跨步相关性的经验参数,范围 0–1,默认 0;越大越重视跨步累积 |
--output |
新建输出目录;最终配置写入 candidates.json |
生成后,在 Python API 中加载所需预算的配置,传给请求的 cache,同时设置 num_steps=40:
import json
from chitu_diffusion import CacheConfig, FreeCacheConfig, FreeCacheProfile

with open("outputs/freecache-40/candidates.json") as f:
    profiles = json.load(f)["profiles"]
profile = next(p for p in profiles if len(p["fresh_steps"]) == 20)
cache = CacheConfig(
    strategy="freecache",
    params=FreeCacheConfig(profile=FreeCacheProfile(**profile)),
)
目前支持单卡确定性 FlowMatch Euler。更换步数或采样设置需要重新标定,不能直接缩放内置的 50 步配置。 请用未参与标定的 prompt / seed 检查速度和画质;拟合目标只是质量的近似。 耗时随样本数和探测位置数增加,命令中的一小时是作业时限,不是完成保证。 独立评测与内置配置的 CPU 复现命令见工具说明。
速度与质量
以下为 2026-09-09 Preview 的同轮参考评测,实际耗时随运行环境和版本变化。 单张 NVIDIA H20,BF16,1024²,50 steps;每个模型使用相同的 3 个 prompt、2 个 seed。 横轴为实测完整生成耗时的加速比,纵轴为相对无缓存结果的 PSNR / 1-LPIPS,越靠右上越好。 LPIPS 在原始 1024² 上计算,不缩放、不裁剪;耗时不含模型加载、图片保存和评测。 CFG 为 Z-Image 5、Qwen-Image 4、FLUX.1-dev 3.5,各方法使用同模型的单卡 torch SDPA 路径。
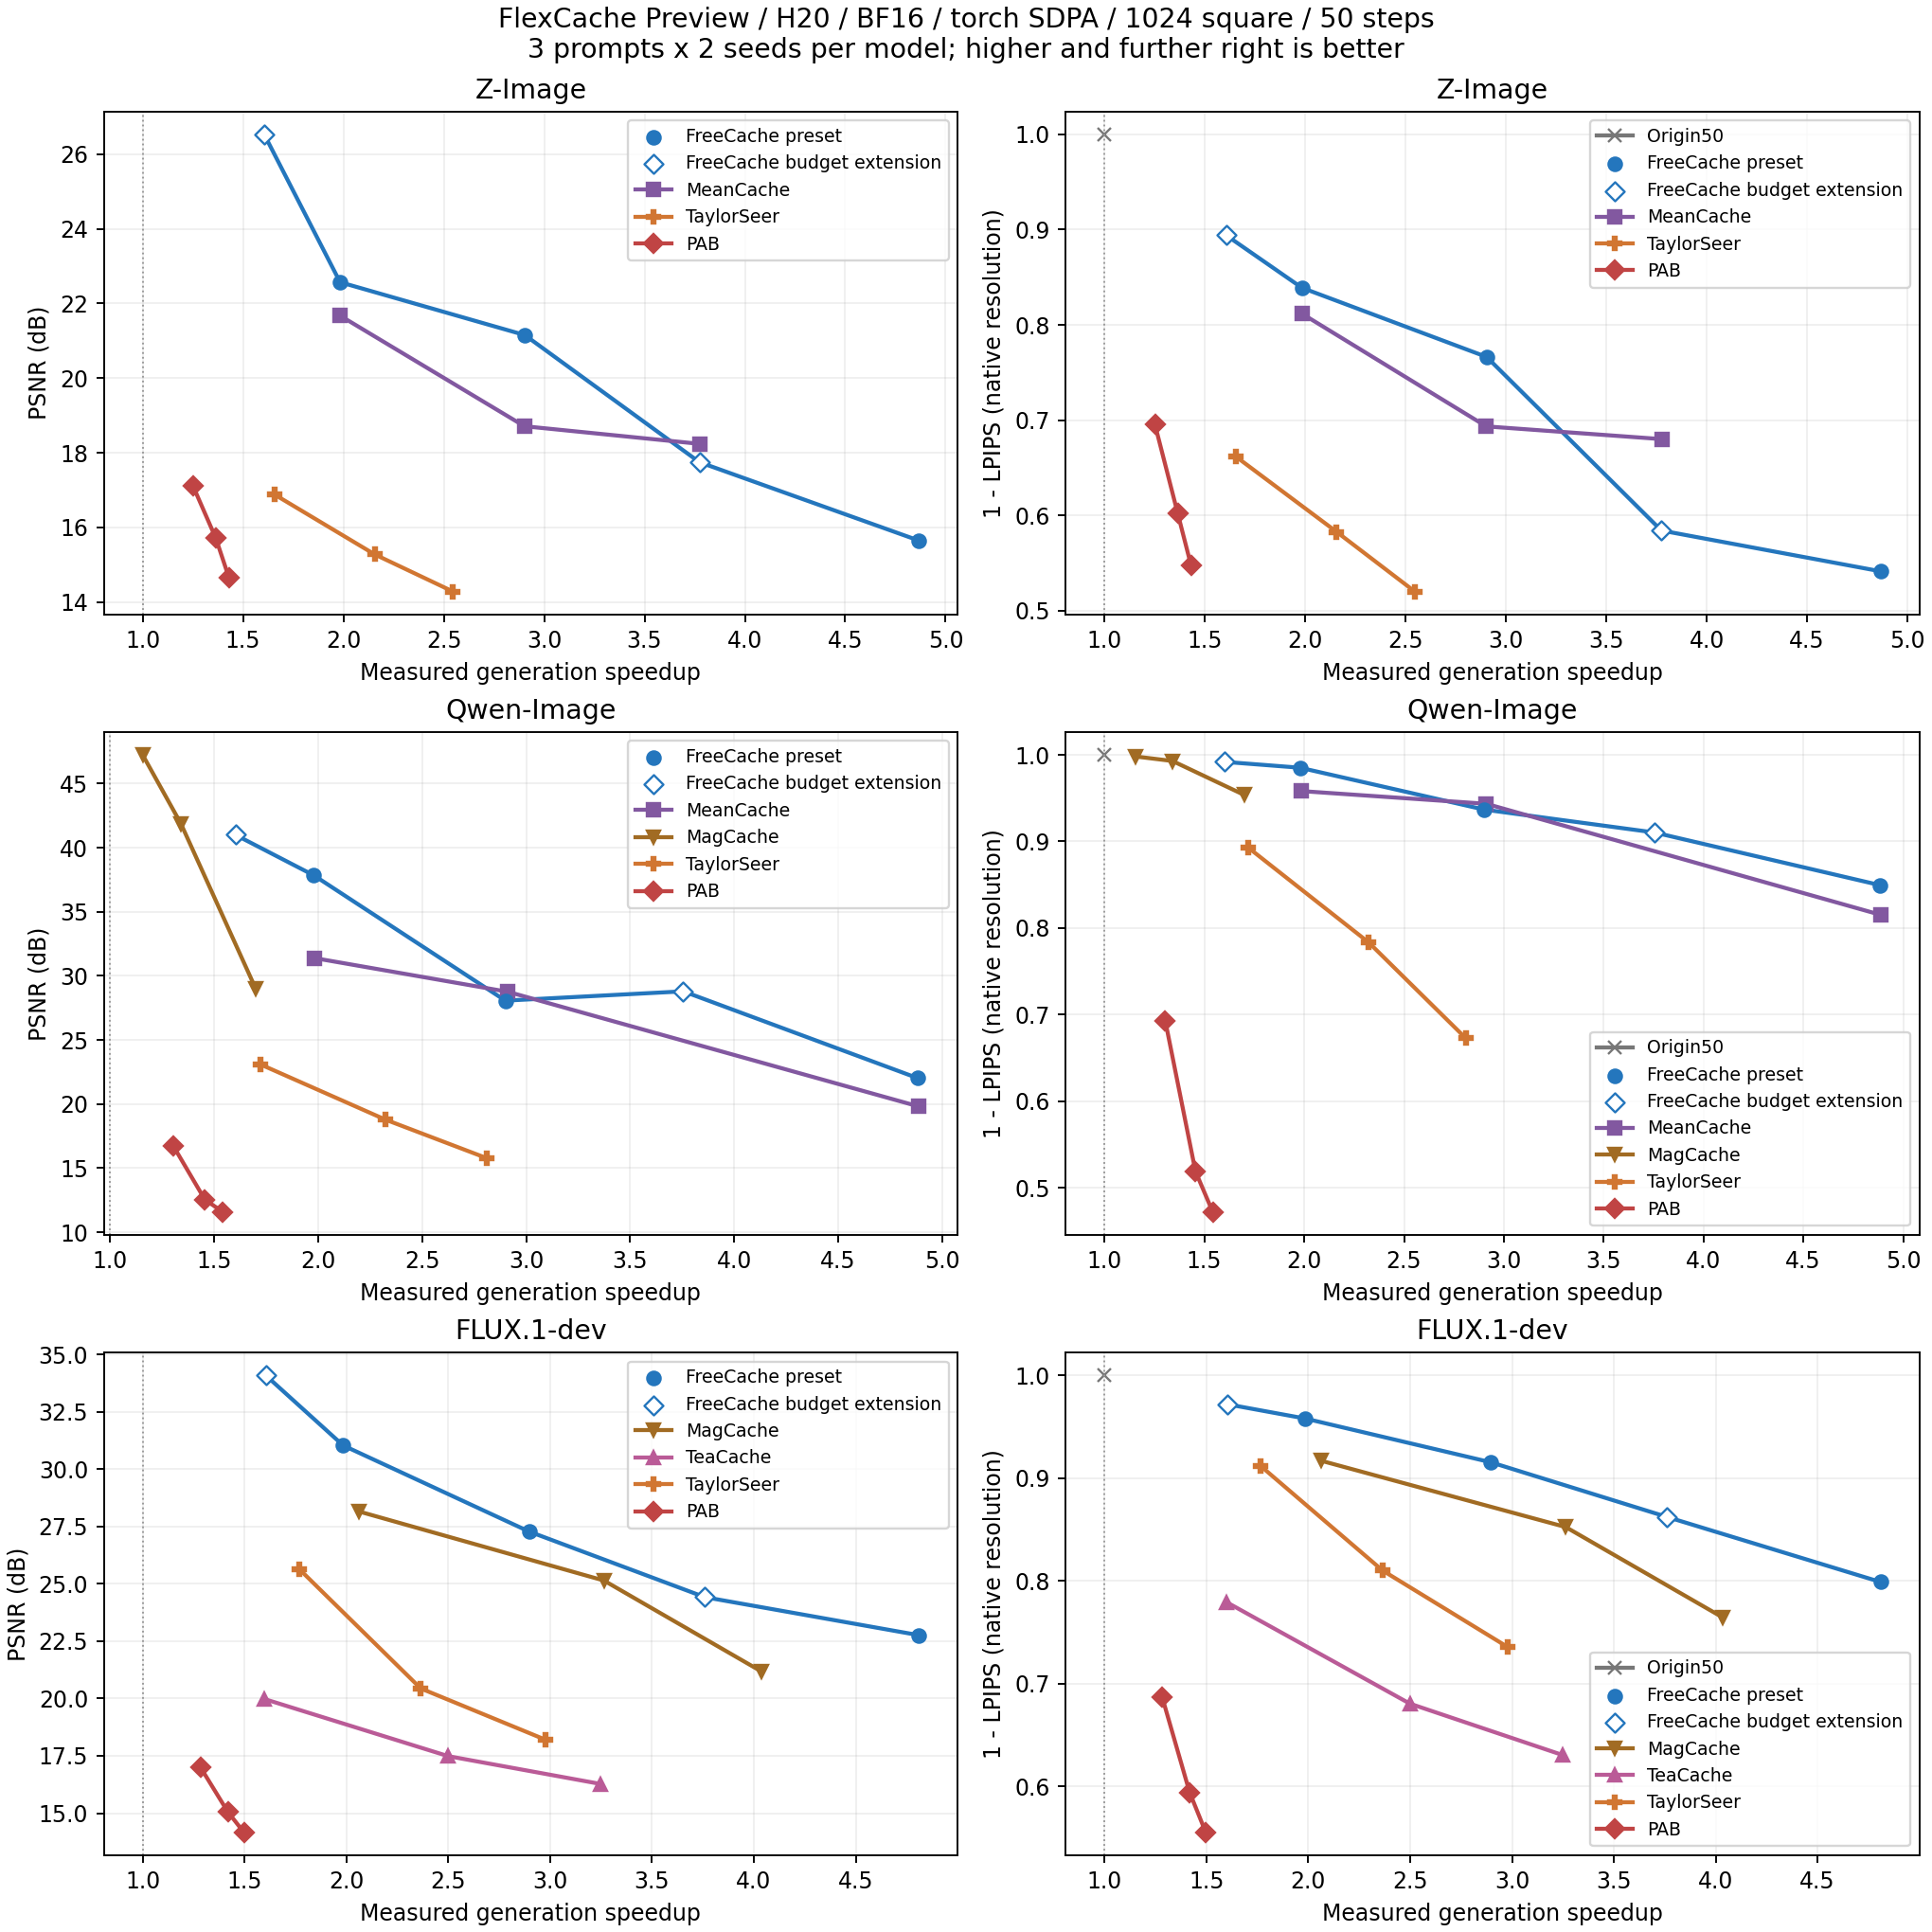
同方法连线连接实测工作点,仅作视觉引导;Origin 的 PSNR 为无穷大,不在 PSNR 轴上人为封顶。 FreeCache 实心圆为 F10 / F17 / F25 定档点,空心菱形为 F13 / F31 自动外推调度的实测点。 全部方法和五个 FreeCache 点在同轮重新测量,加速比相对于同轮 Origin。 图中只比较各模型支持的方法:TeaCache 在 FLUX 上测量,MagCache 在 Qwen/FLUX 上测量, MeanCache 在 Z-Image/Qwen 上测量;FreeCache、TaylorSeer 和 PAB 覆盖三个模型。
FreeCache 工作点
| 模型 | Fresh 预算 | 生成耗时 | 加速 | PSNR ↑ | 1-LPIPS ↑ |
|---|---|---|---|---|---|
| Z-Image | F31(外推) | 30.82s | 1.61x | 26.53 | 0.8942 |
| Z-Image | F25 | 24.95s | 1.98x | 22.57 | 0.8389 |
| Z-Image | F17 | 17.04s | 2.90x | 21.16 | 0.7663 |
| Z-Image | F13(外推) | 13.11s | 3.77x | 17.75 | 0.5840 |
| Z-Image | F10 | 10.17s | 4.87x | 15.65 | 0.5412 |
| Qwen-Image | F31(外推) | 38.24s | 1.60x | 41.00 | 0.9919 |
| Qwen-Image | F25 | 30.95s | 1.98x | 37.84 | 0.9852 |
| Qwen-Image | F17 | 21.13s | 2.90x | 28.06 | 0.9369 |
| Qwen-Image | F13(外推) | 16.32s | 3.75x | 28.79 | 0.9103 |
| Qwen-Image | F10 | 12.55s | 4.88x | 22.01 | 0.8496 |
| FLUX.1-dev | F31(外推) | 20.33s | 1.60x | 34.09 | 0.9718 |
| FLUX.1-dev | F25 | 16.44s | 1.98x | 31.03 | 0.9580 |
| FLUX.1-dev | F17 | 11.26s | 2.90x | 27.28 | 0.9154 |
| FLUX.1-dev | F13(外推) | 8.68s | 3.76x | 24.42 | 0.8623 |
| FLUX.1-dev | F10 | 6.78s | 4.81x | 22.76 | 0.7989 |
画面对比
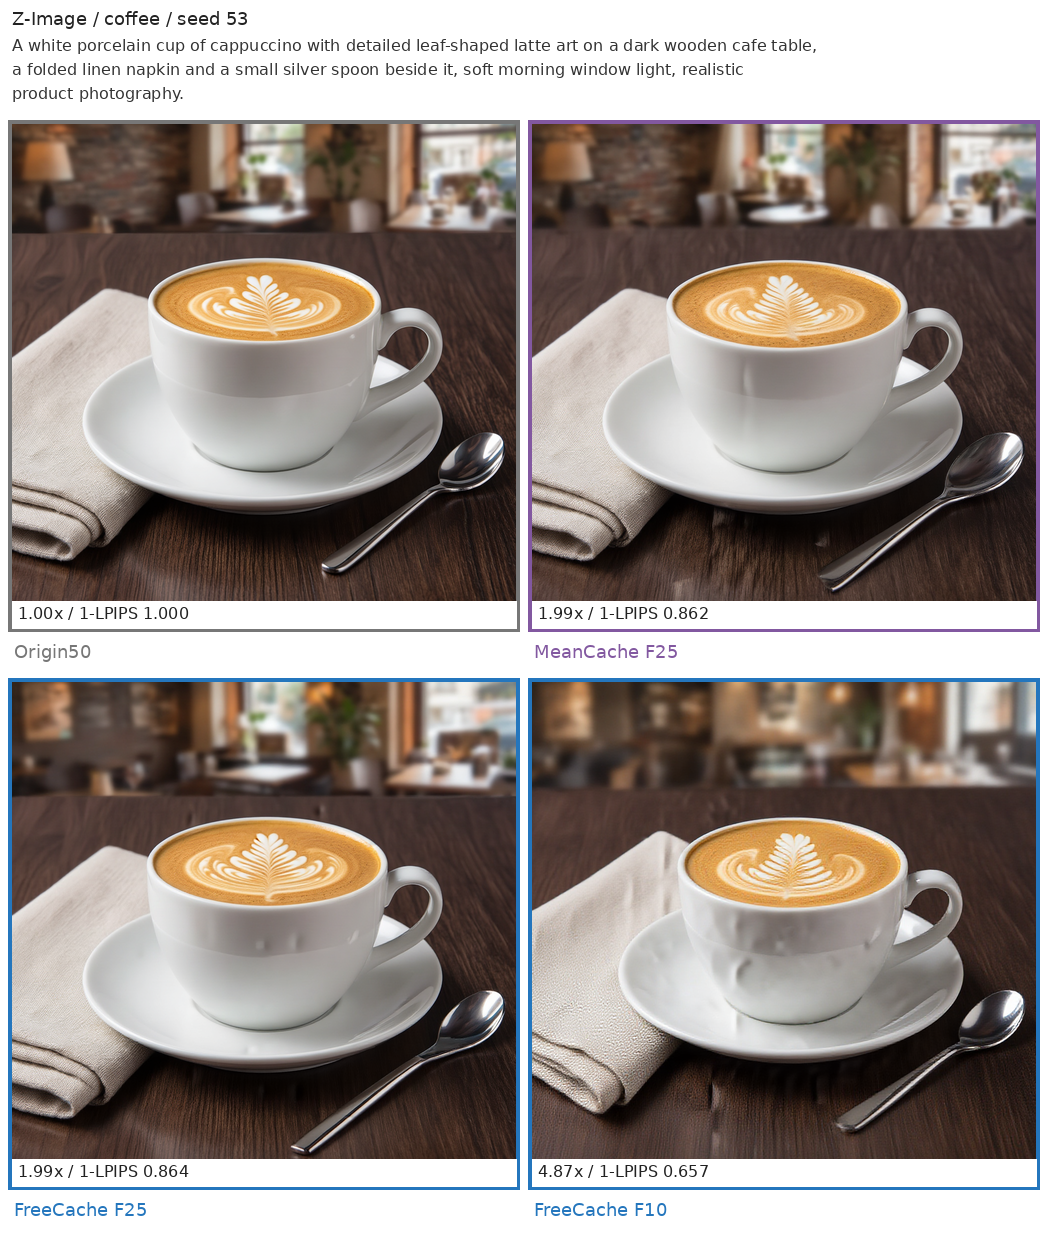
拼图缩小展示;指标使用原尺寸图片计算。
其他策略用法
chitu generate --model flux1 --model-path /path/to/Flux-1 \
  --prompt "A porcelain coffee cup on a cafe table, soft morning light." \
  --steps 50 --cache-strategy magcache --output outputs/coffee-magcache.png
Python API 同样通过 CacheConfig(strategy=..., params=...) 选择策略。
每次 generate() 独立维护缓存,请求结束后恢复临时 hook,不跨请求复用状态。
FreeCache 仅支持单卡的确定性 FlowMatch Euler generate();内置 Preview 为 50 步,自定义配置使用标定时的步数。
其他策略可按模型支持范围使用静态 NCCL CP / Fast CP。均不支持 EPE serve。
所有缓存策略都是有损加速。更换模型、采样参数或缓存档位后,应检查生成结果;
需要保持原始结果时使用 --cache-strategy none。